Zhiqin Xu: Understanding reasoning of LLM via condensation
Zhiqin Xu: Comprendre le raisonnement des LLM via la condensation
Historique des titres
- Zhiqin Xu: Understanding reasoning of LLM via condensation — observé le 20261029-1051 UTC (YouTube)
Mots-clés
Résumé
236 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur des informations est élevée : l’orateur présente un cadre conceptuel original reliant condensation (phénomène d’agrégation des neurones) à la capacité de raisonnement. L’argumentation s’appuie sur une progression logique allant d’exemples simples à des validations expérimentales sur des modèles plus grands. Il prend soin de justifier chaque affirmation avec des expériences contrôlées et des visualisations. La découverte de l’importance du paramètre epsilon de normalisation lors de l’initialisation montre une analyse minutieuse. L’argument selon lequel la condensation réduit la complexité effective est convaincant, et il est appuyé par des mesures de corrélation. La section sur l’attention sink est intéressante mais moins approfondie. Dans l’ensemble, l’argumentation est rigoureuse et bien structurée.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est bonne : l’orateur cite un livre qu’il a écrit et mentionne des expériences avec des codes sources ouverts. Il ne donne pas de références bibliographiques précises dans la vidéo, mais renvoie à son livre pour les détails. La description fournit le lien vers ce livre (PDF). L’adéquation titre-contenu est parfaite : le contenu traite exactement de la compréhension du raisonnement des LLM via la condensation. La chaîne ‘One world theoretical machine learning’ semble spécialisée, et la présentation est technique. On note l’absence de sources externes dans la vidéo, mais le fait qu’il s’agisse d’une conférence académique compense. L’auteur est un professeur reconnu dans le domaine.
234 mots
Adéquation titre / contenu
Le titre reflète exactement le contenu : la présentation explique comment la condensation dans l'espace des poids améliore le raisonnement des LLM.
Qualité & fiabilité
8/10
Présentation par un professeur de mathématiques appliquées, reposant sur des expériences détaillées et un livre publié. Les résultats semblent robustes, mais sans évaluation externe dans la vidéo.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction et présentation de l'orateur
- Définition de mémorisation vs raisonnement avec exemples historiques
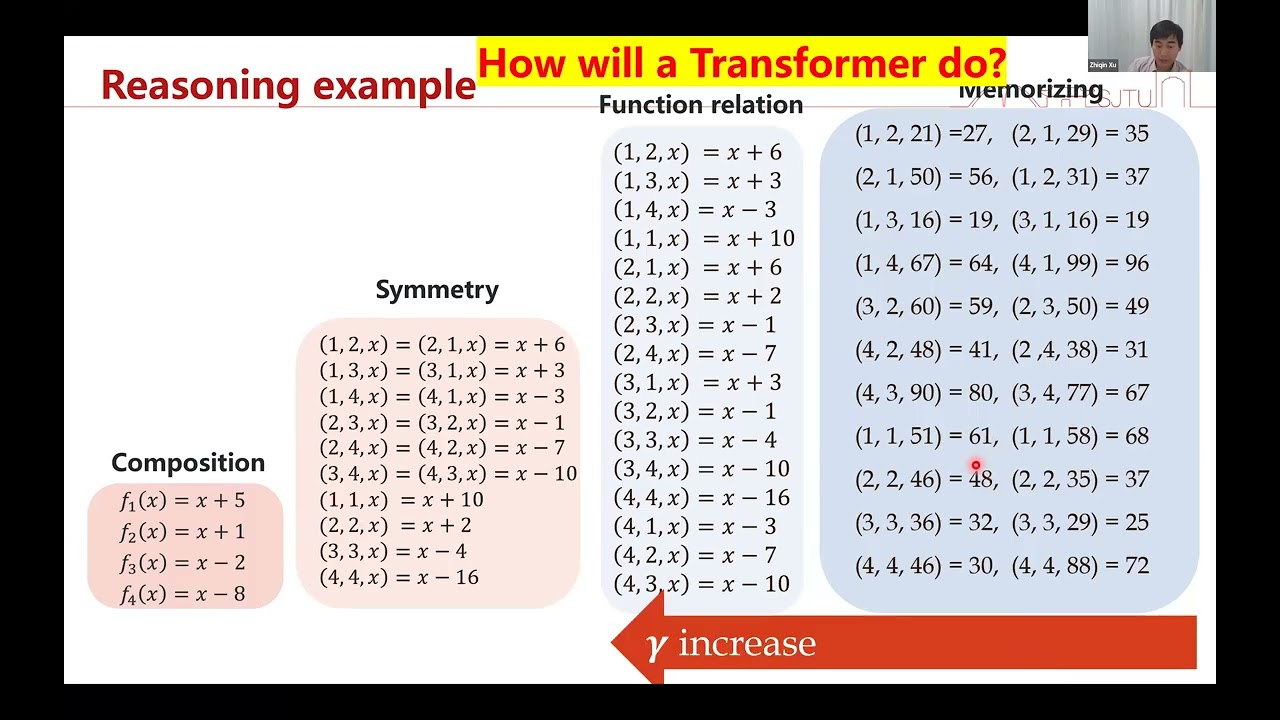
- Conception d'une tâche arithmétique jouet et analyse des relations fonctionnelles
- Introduction du paramètre gamma et son effet sur la condensation
- Visualisation de la condensation dans un réseau simple et lien avec la surparamétrisation
- Application à un modèle de diffusion : amélioration de la généralisation via gamma
- Expériences sur LLM jusqu'à 1,5B, rôle d'epsilon et attention sink
- Conclusion et recommandations
Sources citées
- Livre : Introduction to Deep Learning (PDF) — Référence principale pour les formules et les résultats présentés dans la conférence.
Apport & nouveautés
L’apport original de cette conférence est de démontrer expérimentalement que la condensation des neurones, contrôlée par l’échelle d’initialisation (paramètre gamma), est un mécanisme central qui permet aux réseaux de neurones et aux LLM d’acquérir des capacités de raisonnement. L’auteur propose une vision unifiée reliant la profondeur de raisonnement à la complexité effective du réseau, et fournit des astuces pratiques (initialisation gamma, ajustement d’epsilon, attention guidée) pour améliorer l’entraînement des grands modèles.
Pour aller plus loin :
- Neural Tangent Kernel — Éclaire la dynamique d’apprentissage à l’initialisation et le rôle de l’échelle.
- Lottery Ticket Hypothesis — Connexion avec la réduction de complexité et la condensation.
- Overfitting — Discussion sur la généralisation et le compromis biais-variance.
114 mots
Profil radar
Le profil radar montre des scores élevés en qualité de l'information et niveau technique, avec une quantité d'information et une fiabilité globale légèrement inférieures. Cela correspond à une conférence dense et spécialisée, bien étayée mais nécessitant une certaine expertise pour être pleinement appréciée.